Acerca de numbertwenty
El nombre
numbertwenty lleva este nombre en homenaje a Diogo Jota, delantero portugués del Liverpool, que vestía la camiseta con el número 20 y tuvo un papel clave en el histórico 20.º título de liga del club, pocas semanas antes de su trágica muerte en un accidente de coche. Falleció junto a su hermano, André Silva.
Este proyecto está dedicado a su memoria, en homenaje al espíritu ofensivo y a la energía incansable que Diogo aportó al juego.
La idea
Los debates futbolísticos giran a menudo en torno a los resultados merecidos. Los aficionados tienen opiniones firmes, pero es matemáticamente difícil cuantificar la impresión que deja un partido. ¿Cómo dar una respuesta objetiva a un debate que suele ser profundamente subjetivo?
Más allá de los xG: limitaciones
Los goles esperados (xG) aportan información valiosa a largo plazo sobre el rendimiento de los equipos, pero a veces no captan la verdadera textura de un partido concreto.
Por ejemplo, si nos basamos estrictamente en los xG y en los modelos de Poisson derivados, siempre debe haber un vencedor: el equipo con más xG. En realidad, aproximadamente el 27–32 % de los partidos terminan en empate según la competición.
Similitud estadística
Para ir más allá de los xG, numbertwenty busca vecinos estadísticos: partidos pasados con perfiles similares dentro de la misma liga o de ligas relacionadas. Al comparar un partido con sus equivalentes históricos más cercanos, el sistema capta mejor el contexto local y las dinámicas sutiles que los xG por sí solos pueden pasar por alto. Este enfoque busca reducir la incertidumbre aleatoria del fútbol: el azar irreducible del resultado de cualquier partido individual.
El modelo se centra en variables como las grandes ocasiones, los tiros a puerta, las posesiones ofensivas, las secuencias de pase, las acciones defensivas y más, y ofrece un resumen compacto pero potente del resultado y el estilo del partido. Aunque los xG ayudan a calibrar las variables, el sistema capta con más fidelidad los matices de cada partido y refleja de forma más realista los empates, las victorias locales o visitantes y los patrones de partido poco frecuentes.
Cómo se mide la similitud
Para cada partido, el modelo no se limita a comparar las estadísticas brutas entre equipos. En su lugar, construye dos vistas complementarias para cada par de variables (equipo frente a rival):
- Diferencia: la brecha bruta entre los dos equipos (por ejemplo, tiros a puerta del equipo 1 − tiros a puerta del equipo 2). Informa del dominio ofensivo o defensivo directo.
- Media armónica: una forma de combinar los totales de ambos equipos que premia los duelos realmente de dos sentidos, no solo el volumen bruto. Un reparto de tiros muy desigual de 30–0 y uno equilibrado de 15–15 pueden parecer idénticos con una suma simple (30 en ambos casos), aunque solo uno refleja un duelo real de dos sentidos; la media armónica los distingue, dando 0 para el caso unilateral y 15 para el equilibrado. Tampoco es simplemente «el menor de los dos números»: 10 contra 20 y 10 contra 100 darían ambos «el equipo más débil hizo 10» con un mínimo simple, pero la media armónica aún los distingue (13,3 frente a 18,2): cuánto más hizo el equipo más fuerte sigue aportando algo de información, incluso cuando el equipo más débil ha fijado claramente el suelo.
En conjunto, estas dos vistas recuperan exactamente la misma información que los dos totales brutos de los equipos, sin perder nada, a la vez que separan quién dominó de cuánto participaron realmente ambos equipos, lo que da una huella del partido más rica que cualquiera de los dos números brutos por separado.
Un espacio de variables fijo y bien probado
Las estadísticas concretas que sigue el modelo (tiros, duelos, volumen de pases, equilibrio territorial, etc.) se seleccionan una sola vez, pronto en el registro histórico, mediante una combinación de comprobaciones de redundancia estadística (eliminando señales casi duplicadas) y de relevancia respecto a los goles realmente marcados. Esa selección se mantiene fija en adelante, en lugar de reajustarse en silencio partido a partido. Probamos un esquema más elaborado que dejaba que la importancia de cada variable derivara continuamente en el tiempo, y comprobamos que añadía inestabilidad sin un beneficio de precisión medible: un espacio de variables más simple y fijo resultó ser a la vez más fácil de verificar y, como mínimo, igual de fiable en la práctica.
Fundamentalmente, el motor aísla matemáticamente las competiciones de clubes de los torneos de selecciones nacionales. Como el fútbol internacional opera con una varianza táctica y una frecuencia distintas, las estadísticas causales y el decaimiento temporal se calculan en dos universos separados, lo que garantiza una contaminación cruzada nula entre la dinámica de los clubes y el comportamiento de las selecciones.
Encontrar los vecinos: ámbitos dinámicos e índice causal
Para cada partido, el modelo recupera los k partidos pasados más cercanos mediante la distancia L2 exacta en un espacio de variables transformado: una auténtica distancia de Mahalanobis, no un atajo diagonal simplificado. En concreto, las diferencias brutas de las variables se rotan y se reescalan (un paso llamado blanqueo) para que las variables que suelen estar correlacionadas ya no «voten dos veces» por el mismo patrón subyacente. Dos partidos que resultan cercanos en este espacio transformado son realmente comparables en todo el perfil estadístico, y no solo parecidos en un puñado de números vagamente relacionados.
La causalidad es una restricción estricta: un partido solo puede compararse con partidos que ocurrieron antes que él. El escalado (estandarización) aplicado a las variables se recalcula en cada momento usando solo datos pasados, de modo que ninguna información futura se filtra nunca en la búsqueda de vecinos. El conjunto de estadísticas que mira el modelo se fija una sola vez, pronto en el registro histórico, y nunca se reordena en silencio después: una decisión deliberada de estabilidad, porque un espacio de variables fijo y bien probado es más fácil de razonar y verificar que uno que se reajusta continuamente.
Los vecinos no proceden solo de la misma competición, sino de un conjunto configurado de competiciones similares, ponderadas y escaladas de forma coherente. Esto amplía el conjunto de partidos comparables cuando una competición es joven o intrínsecamente poco común, sin sacrificar relevancia. El motor utiliza un sistema de ámbitos dinámicos 100 % guiado por los datos. Construye algorítmicamente el conjunto de partidos vecinos estadísticamente más relevante evaluando aproximaciones de la distancia de Wasserstein (comparando medias y varianzas de las variables). A medida que una competición acumula suficientes partidos históricos propios, esos conjuntos externos van desapareciendo de forma progresiva y automática.
De los vecinos a las probabilidades: la calibración bayesiana ortogonal de 9 estados
Una vez identificados los k vecinos más cercanos de un partido, cada vecino vota por un resultado (victoria del equipo 1, empate o victoria del equipo 2) según lo que ocurrió realmente en ese partido. Los votos se ponderan con un núcleo de Cauchy de cola pesada sobre las distancias, en lugar de una alternativa más abrupta y de decaimiento más rápido: los vecinos más cercanos siguen pesando más, pero la caída es más suave, porque los partidos de fútbol realmente comparables no son, en la práctica, tan raros; un núcleo de cola más pesada es un a priori más honesto sobre la rapidez con que debe declinar realmente la relevancia de un vecino con la distancia. Esta ponderación se normaliza con la distribución histórica de distancias propia de la competición, de modo que la «cercanía» se evalúe siempre en relación con lo que es típico en esa competición concreta.
Para eliminar los retoques manuales y el escalado de temperatura ad hoc, las estimaciones brutas de probabilidad se procesan mediante una calibración bayesiana ortogonal de 9 estados. En lugar de usar un proceso de ajuste iterativo, nuestro motor clasifica cada partido en una matriz ortogonal de 9 estados que cruza simultáneamente los resultados 1X2, más/menos de 2,5 goles y ambos equipos marcan.
Al calcular distribuciones de Dirichlet a posteriori directamente a partir del historial acumulado de la competición, el sistema actualiza dinámicamente sus hiperparámetros alfa sin un solo número mágico. Esta calibración bayesiana jerárquica garantiza que la distribución prevista de resultados coincida a la perfección con la realidad observada de esa liga concreta, eliminando el sesgo sistemático a favor de la victoria local que aparece de forma natural en los grandes conjuntos de vecinos y preservando un rigor matemático absoluto.
Más allá de las probabilidades 1 / X / 2, los mismos votos de los vecinos se usan para producir una distribución de marcadores: cada vecino aporta su marcador final real (por ejemplo, 1–0, 2–1, 0–0), ponderado por su voto con núcleo de Cauchy. El resultado es una lista ordenada de los marcadores exactos más probables para cada partido, una imagen más fina del resultado probable que el reparto en tres resultados por sí solo.
Explicar un partido: la pestaña Claves
Una probabilidad es solo la mitad de la historia: la pestaña Claves de cada página de partido responde a la pregunta siguiente: ¿por qué llegó el modelo a ese número? Lo hace en tres niveles, cada uno de los cuales responde a una pregunta realmente distinta:
- Extremidad: para cada estadística, ¿cuán inusual fue este partido, un número cada vez? Un número de tiros situado en el percentil 96 es raro por sí solo, con independencia de todo lo demás que ocurriera en el partido.
- Contribución de las variables (vecindario): ¿qué estadísticas guiaron realmente la elección de estas comparaciones históricas concretas, aquellas con las que el modelo vota ahora mismo?
- Por qué destaca este partido (global): con independencia de cualquier vecino concreto, qué estadísticas hicieron inusual el perfil completo de este partido y en qué dirección. Algunas pueden incluso empujar en sentido contrario y hacer que el partido parezca más típico en lugar de menos. Esta puntuación tiene en cuenta la correlación entre estadísticas: si dos números suelen moverse juntos, un valor extremo en uno puede explicarse en gran parte porque el otro ya es extremo, y por tanto aporta poco realmente nuevo, aunque su propio percentil, tomado aislado, parezca llamativo. Por eso el tercer panel puede clasificar las cosas de otra manera que el primero: responden a preguntas distintas, no se contradicen sobre la misma.
Junto con un único número principal (el porcentaje de partidos de nuestra base de datos cuyo perfil global fue menos inusual que el de este partido), esto ofrece una cadena completa y trazable desde una cifra de conjunto hasta las estadísticas exactas que la sustentan, sin dejar nada en una caja negra.
Cuantificar la incertidumbre a todas las escalas
Un gran avance de nuestra arquitectura es la cuantificación de la incertidumbre (varianza) a todas las escalas. Una distribución de probabilidad está incompleta si no se sabe cuán sólida es realmente la estimación. Nuestro motor calcula matemáticamente la varianza total de cada resultado previsto fusionando dos capas distintas:
- Varianza aleatoria (Dirichlet): el azar natural e irreducible del resultado del partido, derivado de la distribución de Dirichlet a posteriori de nuestra calibración de 9 estados.
- Inflación epistémica (Student-t y distancia espacial): al evaluar un equipo o una competición con pocos partidos (tamaño efectivo de muestra bajo), o cuando el perfil de un partido es estadísticamente único (gran distancia geométrica en el espacio vectorial FAISS), el modelo tiene incertidumbre sobre la media real. Aplicando los principios de la distribución predictiva de Student-t y una penalización por razón espacial, el motor infla analíticamente la varianza.
Contextualizar la dificultad del campo
Las estadísticas brutas nunca se evalúan en el vacío. Generar 2,0 goles esperados y 15 tiros en casa es un indicador estándar de control; sin embargo, reproducir exactamente esas mismas métricas fuera de casa exige un nivel de rendimiento subyacente bastante superior.
Como el sistema busca vecinos estadísticos exactos y calibra las probabilidades a partir de referencias históricas, tiene en cuenta intrínsecamente la dificultad estructural de jugar fuera de casa. En consecuencia, si un equipo visitante iguala la producción estadística bruta del equipo local, el modelo asignará con frecuencia una probabilidad justa de victoria más alta al visitante, reconociendo matemáticamente el mayor esfuerzo necesario para alcanzar la paridad estadística a domicilio ajeno.
Interpretación
El modelo pretende extraer la realidad estadística subyacente de un partido filtrando el ruido aleatorio inherente al fútbol, como una varianza extrema en la definición, una actuación excepcional del portero o la mera suerte. Responde a una pregunta fundamental: dada la huella multidimensional exacta de las estadísticas producidas por ambos equipos, ¿qué distribución de resultados dicta el precedente histórico?
El modelo se basa en estadísticas agregadas del partido completo y puede evaluar si el marcador final concuerda con lo que sugiere un conjunto comparable de partidos históricos. En lugar de dictar lo que un equipo «debería» haber marcado, traslada el rendimiento a una distribución realista de probabilidades.
Sin embargo, no capta la evolución minuto a minuto: no puede saber si un gol llegó pronto o tarde, ni cómo cambió el impulso del partido (por ejemplo, con tarjetas rojas). Es una limitación conocida, pero también refleja la producción real: un equipo que se replegó a defender tras marcar pronto produjo, o no, algo a lo largo de 90 minutos, y el modelo lo lee con honestidad.
El análisis muestra que aproximadamente el 34 % de los partidos (un tercio de los partidos de fútbol) terminan con un resultado que va en contra de lo que sugieren las estadísticas. Con un margen del 5 % respecto al resultado más probable, esta cifra baja al 26 %. El fútbol es intrínsecamente aleatorio y el modelo está diseñado para dejar a la vista esa realidad en lugar de ocultarla.
Leer las probabilidades
Una primera idea errónea: unas probabilidades ajustadas como 33 % / 34 % / 33 % no significan que el empate fuera el resultado más probable. Significan que cada uno de los tres resultados tenía una probabilidad igual de producirse según la evidencia histórica. Las probabilidades cercanas reflejan incertidumbre, no una preferencia por los empates. El resultado real fue simplemente el que se materializó entre tres escenarios más o menos equiprobables.
Una segunda idea errónea se refiere a la amplitud de las probabilidades de empate. Para las victorias locales y visitantes, el modelo puede alcanzar a veces valores muy altos, en ocasiones por encima del 90 %, cuando el dominio estadístico es abrumador. Para los empates, esa amplitud es estructuralmente menor: una señal de empate del 40-45 % o más ya es una señal fuerte.
Es una consecuencia directa de cómo funciona la calibración. La calibración asegura que la proporción de partidos previstos como empate coincida con la tasa real de empates observada en la competición (normalmente 27–32 %). Como el empate es el resultado más raro del fútbol, el conjunto de partidos vecinos contiene naturalmente menos. Por tanto, la calibración solo necesita aplicar un peso moderado a los votos de empate para alcanzar la proporción histórica correcta; no tiene motivo para ir más allá. Mecánicamente, la probabilidad de empate solo puede crecer lo necesario para reproducir la frecuencia de empates de la competición. Una vez alcanzado ese objetivo, el algoritmo converge. El resultado es que las probabilidades de empate tendrán estructuralmente un rango más estrecho que las de victoria, y deben interpretarse en consecuencia.
Preguntas frecuentes
¿Qué es numbertwenty.io?
numbertwenty es una plataforma de análisis de fútbol diseñada para responder a una pregunta subjetiva con matemáticas objetivas: «¿Quién merecía realmente ganar?» Al analizar la huella estadística de un partido pasado (en 90 minutos, sin prórroga), nuestro motor determina la distribución real de probabilidades y el marcador más justo según la historia del fútbol.
¿Predice el futuro?
No, nuestro objetivo principal es analizar y cuantificar el pasado. El propósito central es aislar la suerte y el ruido aleatorio de los partidos ya jugados para comprender la realidad estadística de un rendimiento. Las proyecciones futuras (como las predicciones a priori o los cuadros de torneo) son simples subproductos matemáticos: para comprender bien el futuro, primero hay que evaluar el pasado con precisión quirúrgica.
¿Por qué ir «más allá de los goles esperados (xG)»?
Los goles esperados (xG) son fantásticos para las tendencias a largo plazo, pero tienen limitaciones importantes en un solo partido. Si nos basamos únicamente en los xG acumulados y en los modelos de Poisson clásicos, el equipo con más xG casi siempre es designado vencedor. En realidad, el fútbol incluye estructuralmente empates (aproximadamente entre el 27 y el 32 % de los partidos según la liga). Nuestro enfoque no se limita a sumar la probabilidad teórica de los tiros: analiza toda la textura del partido para restituir la verdadera probabilidad histórica de los empates, las victorias por la mínima y los escenarios raros.
¿Por qué las probabilidades de empate rara vez superan el 45 %?
Es una propiedad fundamental de nuestro proceso de calibración. Como los empates son estadísticamente más raros que las victorias locales en el fútbol, nuestro algoritmo garantiza que la distribución de probabilidades refleje con exactitud la realidad de cada competición. Una probabilidad de empate mostrada al 45 % es en realidad una señal extremadamente fuerte de neutralización, ya que se sitúa muy por encima de la media histórica de referencia (27–32 %). Inflar artificialmente las probabilidades de empate hasta el 70 % introduciría un sesgo estadístico importante.
¿Cómo se gestionan los campos neutrales o los torneos internacionales?
Los partidos en campo neutral (como el Mundial) tienen por naturaleza menos datos históricos. Para compensarlo, nuestro motor usa una búsqueda en espejo: busca partidos similares desde ambas perspectivas (intercambiando los papeles de equipo y rival) y fusiona los resultados. Además, las competiciones internacionales se rigen por un reloj basado en eventos en lugar de un reloj de calendario, lo que evita la pérdida de memoria estadística durante los años que separan los torneos. Por último, nuestros ámbitos dinámicos 100 % guiados por los datos se amplían automáticamente a competiciones homólogas similares hasta reunir suficiente historial local.
¿Cómo se gestiona la ventaja de jugar en casa?
Tratamos la ventaja de jugar en casa como un a priori estructural dentro de nuestro proceso de inferencia, en lugar de una corrección externa. Si una liga tiende históricamente al 45 % de victorias locales, nuestro modelo se optimiza para respetar esa distribución sobre una muestra grande, sin forzar a que cada partido individual regrese a la media. Para los campos neutrales, el modelo aplica un tratamiento simétrico neutralizando los coeficientes de resultado.
¿Por qué se excluyen las tarjetas rojas del análisis?
Las tarjetas rojas se excluyen intencionadamente para no codificar «ruido de estado de juego». Como nuestro modelo trabaja con estadísticas agregadas del partido completo, carece del contexto temporal para distinguir una tarjeta roja en el minuto 5 de una en el minuto 94. Incluirlas arriesgaría contaminar nuestra recuperación de vecinos con una similitud espuria.
¿Por qué hay dos clasificaciones distintas (esperada y proyectada)?
La clasificación esperada recalcula la tabla de la liga con puntos fraccionarios basados en las probabilidades justas de los partidos ya jugados. Los puntos otorgados por partido siguen la esperanza matemática: 3 × P(victoria) + 1 × P(empate) (por ejemplo, un equipo con un 50 % de victoria y un 30 % de empate obtiene 1,8 puntos). La clasificación proyectada toma la clasificación oficial actual y le suma esta esperanza matemática de puntos para todos los partidos futuros restantes.
Auditoría de apuestas postpartido
Una función de evaluación posterior al partido que analiza tus elecciones (simples o combinadas). En lugar de basarse únicamente en el resultado final, que a menudo está sesgado por la varianza inherente al fútbol, la auditoría contrasta tus elecciones con la realidad estadística producida sobre el campo. Así determina la verdadera probabilidad empírica que tenía tu boleto de ganar y te permite evaluar la calidad de tu análisis con total independencia de la suerte.
¿Cómo cuantifica el modelo la incertidumbre y la confianza?
A diferencia de los motores tradicionales que ofrecen probabilidades estáticas, numbertwenty calcula la varianza matemática exacta a todas las escalas temporales y espaciales. Al combinar una distribución de Student-t (incertidumbre epistémica por el tamaño de las muestras) con distribuciones de Dirichlet (ruido aleatorio) y la distancia geométrica espacial en el espacio vectorial de vecinos, el sistema te dice con exactitud cuán «cierta» o «inestable» es una estimación de probabilidad justa. En las tarjetas de partido, esto se representa visualmente como una banda de incertidumbre de 1 sigma (±1σ) que destaca estrictamente la zona de confusión.
¿Está numbertwenty disponible en otros idiomas?
Sí. Todo el sitio está disponible en inglés, francés y español. En tu primera visita, el idioma sigue la preferencia de tu navegador; puedes cambiarlo en cualquier momento desde la cabecera y tu elección se recuerda. Los análisis de partido están redactados en inglés y pueden traducirse al instante desde la pestaña Análisis.
¿Necesito una cuenta? ¿Puedo personalizar el sitio?
No hace falta ninguna cuenta. Puedes marcar equipos como favoritos para que sus partidos se agrupen en un bloque propio en la página de inicio, y alternar entre la vista de lista y la vista detallada de las tarjetas de partido. Estas preferencias se guardan solo en tu navegador y nunca se nos envían, así que permanecen en el dispositivo donde las configuraste. Las listas de partidos y las clasificaciones también se actualizan solas a medida que llegan nuevos resultados.
¿Qué es la pestaña Claves y cómo debo leerla?
Es la explicación que el modelo da de sí mismo para un partido concreto, en tres niveles de detalle: cuán inusual fue cada estadística individual (Extremidad), qué estadísticas guiaron realmente la selección de los partidos históricos usados como comparaciones (Contribución de las variables, vecindario) y qué estadísticas hicieron destacar el perfil global del partido, con independencia de cualquier vecino concreto (Por qué destaca este partido). Un percentil principal en la parte superior resume el último de estos niveles en un solo número. Cada cifra remite a una estadística de partido real y con nombre: nada de esto procede de una señal interna inexplicable.
¿Por qué los percentiles de extremidad y la contribución de las variables a veces discrepan?
Responden a preguntas distintas a propósito. Un percentil mira una estadística de forma aislada: ¿cuán raro es este número por sí solo? La puntuación «Por qué destaca este partido» mira todas las estadísticas juntas y tiene en cuenta cómo suelen moverse unas respecto a otras. Si dos estadísticas suelen estar correlacionadas, un valor extremo en una de ellas puede explicarse en gran parte porque la otra ya es extrema, por lo que aporta comparativamente poco realmente nuevo a la inusualidad global del partido, aunque su propio percentil pueda parecer llamativo por sí solo. Ninguno de los dos números es erróneo; simplemente miden cosas distintas.
Glosario y conceptos clave
Vecino estadístico
Cuando termina un partido, nuestro algoritmo extrae su firma matemática (tiros a puerta, secuencias de pase, volumen defensivo, etc.). A continuación, recorre nuestra base de datos histórica para localizar partidos pasados que mostraron estadísticas casi idénticas. Observando cómo terminaron realmente en su día esos partidos cercanos, nuestro sistema establece un mapa probabilístico honesto y concreto del resultado más justo para cualquier partido.
Motor Fair Elo
A diferencia de las clasificaciones clásicas, que otorgan todos los puntos al ganador sin importar cómo jugó, el sistema Fair Elo reparte los puntos de valoración según las probabilidades justas del partido evaluadas después del encuentro. Utiliza un modelo híbrido de élite que combina un sistema Glicko-2 a nivel micro para las actualizaciones entre equipos (con penalizaciones dinámicas por inactividad y multiplicadores de importancia del partido) con un seguidor TrueSkill a nivel macro que evalúa ligas y confederaciones enteras.
Percentil
En cada página de partido, el relleno de las barras de estadísticas no representa el valor bruto, sino el percentil de ese rendimiento respecto a un ámbito de referencia (por ejemplo, los últimos 365 días). Fundamentalmente, estos percentiles aplican una causalidad estricta: se calculan hasta la fecha exacta del partido usando solo los datos disponibles en ese momento, para evitar la filtración de datos futuros.
Resultado justo (a posteriori)
La distribución de probabilidades (1 / X / 2) calculada después del partido a partir de las estadísticas reales producidas por ambos equipos durante los 90 minutos. Representa lo que la evidencia histórica dice que el resultado debería reflejar.
Resultado previsto (a priori)
La probabilidad teórica calculada antes del pitido inicial, basada exclusivamente en la fuerza intrínseca de los equipos (Fair Elo) y en la dinámica de su forma reciente, antes de que se toque un solo balón.
Incertidumbre aleatoria frente a epistémica
Nuestra arquitectura matemática separa dos tipos de incertidumbre: la incertidumbre aleatoria es el azar caótico e irreducible inherente a un partido (un mal bote, un palo, errores arbitrales). La incertidumbre epistémica refleja el nivel de confianza de nuestra estimación estadística, determinado por el tamaño de la muestra histórica (N_eff) y la distancia geométrica de los vecinos estadísticos. Ambas se modelan rigurosamente en una métrica de varianza total.
Bayes empírico y cero números mágicos
En el modelado tradicional, a menudo se retocan a mano constantes arbitrarias o pesos ad hoc («números mágicos») para forzar la convergencia del modelo. En numbertwenty, todos los parámetros de contracción, los pesos a priori y los ámbitos dinámicos están 100 % guiados por los datos. Mediante estimadores bayesianos empíricos, el motor aprende dinámicamente la razón de varianza exacta entre las competiciones locales y las medias globales para ajustarse de forma autónoma.
Calibración bayesiana de 9 estados
En lugar de calibrar los resultados de los partidos mediante un simple escalado iterativo, nuestro motor proyecta cada partido en una matriz ortogonal de 9 estados que combina los resultados 1X2, más/menos de 2,5 goles y ambos equipos marcan. Esta calibración bayesiana jerárquica cerrada garantiza que las distribuciones de marcadores justos y los totales de goles preserven de forma natural la geometría histórica auténtica de cada liga.
Puntuación de atipicidad
Un único número, expresado como percentil, que resume cuán inusual fue el perfil estadístico completo de un partido en comparación con todos los demás partidos de nuestra base de datos: no una estadística cada vez, sino la imagen completa de golpe, en el mismo espacio transformado que usa el modelo para encontrar vecinos. Es la cifra principal en la parte superior de la pestaña Claves y procede del mismo cálculo que la puntuación de singularidad que se muestra en las tarjetas de partido.
Contribución de las variables
Un desglose exacto y con signo de la puntuación de atipicidad, estadística por estadística: ¿cuánto empujó cada número individual al partido hacia lo inusual (o, en algunos casos, lo devolvió hacia lo típico)? A diferencia de un percentil bruto, tiene en cuenta la correlación entre estadísticas: un valor extremo en una estadística que se explica en gran parte porque otra estadística relacionada ya es extrema contribuye aquí comparativamente poco, aunque su propio percentil pueda parecer llamativo por sí solo.
Barras de estadísticas y percentiles
En cada página de partido (y en el comparador de partidos), un conjunto de barras de estadísticas muestra el rendimiento de cada equipo en las métricas clave. El relleno de cada barra no representa el valor bruto: representa el percentil de ese rendimiento respecto a un ámbito y un periodo de referencia elegidos por el usuario: solo la competición, todas las competiciones, los últimos 365 días o el conjunto histórico completo.
Fundamentalmente, estos percentiles aplican una causalidad estricta para evitar la filtración de datos futuros. Se calculan hasta la fecha exacta del partido, usando solo los datos disponibles en ese momento preciso. Esto significa que dos partidos de la misma competición con estadísticas brutas idénticas pueden mostrar rellenos de percentil distintos si ocurrieron en momentos diferentes de la temporada. Este diseño intencionado garantiza que todas las evaluaciones sigan siendo históricamente auténticas y contextualmente justas.
Cuando el conjunto de referencia local es pequeño, por ejemplo una competición joven con pocos partidos o una ventana temporal estrecha, los percentiles se mezclan automáticamente con percentiles globales calculados sobre todas las competiciones y fechas. Esta contracción evita valores de percentil extremos o sin sentido cuando hay pocos datos, y a la vez refleja el contexto local en cuanto existen suficientes partidos.
También se respeta el contexto del campo: los percentiles de un partido en casa se calculan únicamente frente a partidos pasados en casa, y los de un partido en campo neutral frente a partidos en casa y neutrales combinados. Así se garantiza que una estadística producida en casa no se compare con rendimientos fuera de casa, lo que distorsionaría injustamente la lectura.
Esto explica también por qué los vecinos más cercanos de un partido pueden parecer tener estadísticas distintas, ya sea en valores brutos o en barras de percentiles. La búsqueda de vecinos opera en el espacio de variables transformado (diferencias, tasas, sumas, escaladas y ponderadas) en lugar de sobre los recuentos brutos. Dos partidos con totales absolutos de tiros distintos pueden ser vecinos muy cercanos si sus tasas y diferencias son similares.
Motor Elo híbrido Glicko-2 y TrueSkill
A diferencia de las clasificaciones clásicas, que otorgan todos los puntos al ganador, el sistema Fair Elo reparte los puntos según las probabilidades justas del partido evaluadas después del encuentro.
Esto significa que, aunque un equipo gane, puede obtener menos puntos que su rival si la evidencia estadística sugiere que fue dominado. Por el contrario, un equipo que pierde aún puede ganar puntos si las probabilidades justas indican que fue el más fuerte ese día. El sistema premia así el mérito en lugar de los resultados brutos.
Formalmente, la actualización de la valoración sigue el marco de Glicko-2 ampliado con un modelo de Bradley-Terry-Davidson para tres resultados (victoria, empate, derrota). Esto significa que un equipo con una racha irregular tendrá mayores oscilaciones de valoración que uno constante con el mismo nivel medio.
Esta dinámica garantiza que ningún equipo reciba nunca todos los puntos ni ninguno, ni siquiera en resultados extremos. El sistema comprime de forma natural el rango del Elo: los equipos excepcionalmente fuertes casi nunca captan el 100 % de los puntos, y los más débiles casi nunca captan cero.
Los partidos entre equipos de competiciones distintas, como las competiciones de clubes de la UEFA, ayudan a calibrar las transferencias entre ligas y propagan la información de valoración a través de las fronteras nacionales. Los partidos internacionales entre confederaciones (por ejemplo, el Mundial) calibran además las valoraciones a nivel de confederación, sobre todo para las selecciones nacionales.
Dinámicas micro y macro
Un modelo Glicko-2 estándar reparte los puntos de forma uniforme dentro de un ecosistema cerrado. Para captar con precisión los cambios a escala macro entre distintas fronteras, el motor se apoya en un sistema híbrido totalmente dinámico de dos capas:
- Micro (Glicko-2): gestiona las actualizaciones directas de valoración entre equipos. Aplica una penalización por inactividad estricta y automática: si un equipo no ha jugado durante mucho tiempo, su valoración decae exponencialmente hacia la media histórica de referencia y su incertidumbre aumenta dinámicamente. El motor también escala de forma nativa la varianza según la importancia matemática del torneo (por ejemplo, grandes copas internacionales frente a amistosos).
- Macro (inspirado en TrueSkill): el motor ejecuta simultáneamente seguidores en la sombra que evalúan la fuerza global de ligas y confederaciones enteras. Cada vez que se juega un partido entre ligas o confederaciones distintas, el seguidor macro desplaza matemáticamente la fuerza base de los ecosistemas correspondientes según el resultado.
Gracias a este sistema tan reactivo, las valoraciones absorben el contexto de forma nativa. Para los clubes, las valoraciones calculadas de liga y confederación se suman activamente, como bonus matemático, a su Elo base final. Para las selecciones nacionales, el motor sigue la fuerza de la confederación en segundo plano, pero se apoya estrictamente en el rendimiento individual a nivel micro para la valoración final. Esto vuelve completamente obsoletos los «Power Index» arbitrarios.
Competiciones y clasificaciones
Huellas analíticas (carruseles de cabecera)
En la parte superior de cada página de competición, un carrusel interactivo muestra la «huella» analítica de la liga. Los usuarios pueden alternar entre dos modos:
- A posteriori (POST): métricas como los «resultados lógicos» y la «doble oportunidad lógica» muestran con qué frecuencia el dominio real sobre el campo coincide con el marcador final, y revelan el nivel de ruido aleatorio inherente a la competición. También registra las distribuciones históricas de los sesgos victoria/empate, más de 2,5 goles y ambos equipos marcan.
- A priori (PRE): evalúa la precisión predictiva previa al partido del modelo para esa liga concreta, con las tasas de acierto en resultados 1X2, doble oportunidad, marcadores exactos y el porcentaje de partidos considerados demasiado caóticos para apostar («tasa de no apuesta»).
Tres modos de clasificación
En cada página de competición, las clasificaciones de los equipos se presentan en tres modos:
- Real: basada en los resultados reales de los partidos tal como figuran en la clasificación oficial.
- Esperada: puntos calculados a partir de las probabilidades justas, concretamente 3 × P(victoria) + 1 × P(empate), para cada partido jugado, con independencia del resultado real.
- Proyectada: proyección de final de temporada que combina la clasificación real actual con los resultados previstos de todos los partidos restantes.
Para las clasificaciones proyectadas hay dos modos de visualización. El modo continuo (habitual en las tablas de xG) reparte puntos fraccionarios proporcionalmente a las probabilidades de cada resultado, y ofrece un reflejo probabilístico preciso de la clasificación final esperada. El modo de resultado mayoritario asigna todos los puntos al único resultado más probable de cada partido, lo que produce una clasificación más discreta con valores más marcados: útil para comparaciones ordinales, pero menos realista como representación de la incertidumbre.
Proyecciones de torneo en directo
Para los formatos de copa (como el Mundial), la plataforma incluye un modelo dinámico de proyección de torneo. Se actualiza automáticamente tras cada partido, proyectando las clasificaciones de grupo y trazando el cuadro final de eliminatorias a partir de las estadísticas y la forma actuales de los equipos. En caso de empate proyectado en la fase eliminatoria, avanza el equipo con mayor probabilidad de clasificarse.
Clasificaciones Fair Elo mundiales
Puedes explorar las clasificaciones mundiales separadas por clubes y naciones. Junto a la puntuación Fair Elo bruta, estas tablas muestran el Δ corto de un equipo (impulso reciente) y su Δ largo (trayectoria de forma a largo plazo).
Casos especiales de partidos
Cuando un partido se suspende o se pierde por incomparecencia y se declara un vencedor administrativamente, los puntos justos de la clasificación esperada se fijan en lugar de derivarse del modelo de probabilidades justas, ya que las estadísticas ya no reflejan un partido completo. Los puntos justos otorgados son: 2 pts para el equipo que ganaba sobre el campo en el momento de la interrupción, 1 pt para el que perdía y 1,5 pts cada uno si el marcador estaba igualado.
Pronósticos y cuotas justas
La plataforma cuenta con una sección específica de Pronósticos que permite explorar los partidos futuros y pasados agrupados por día, competición o equipo.
Para cada partido puedes comparar la previsión (la predicción a priori hecha antes del partido a partir del Elo y la forma) con el resultado justo (la probabilidad a posteriori calculada después del partido a partir de las estadísticas reales). Esta vista en paralelo revela al instante si un partido se desarrolló como anticipaba el modelo previo.
Además, la tabla ofrece cuotas justas (a priori) para los mercados 1 / X / 2. Se derivan matemáticamente de las probabilidades previas al partido del modelo. Funcionan como un indicador de referencia estricto: si una casa de apuestas ofrece una cuota superior a nuestras cuotas justas, teóricamente representa una apuesta de valor según nuestro marco estadístico.
Filtro de confianza dinámico
En la sección de Pronósticos, los usuarios disponen de un control deslizante de filtro de confianza (ajustable del 50 % al 99 %). Esta herramienta traduce algorítmicamente el porcentaje elegido en un umbral estadístico de puntuación Z.
Al mover el control deslizante, la interfaz evalúa al instante los límites de incertidumbre ±1σ de cada partido. Si la varianza es demasiado alta y las bandas de probabilidad se solapan de forma notable, el partido se marca como «No concluyente» o «Cara o cruz». Esto te permite filtrar visualmente los partidos caóticos y centrarte exclusivamente en los pronósticos en los que el modelo indica un dominio claro y estadísticamente significativo.
Los resultados más injustos de la semana
La página Injusticias recoge, semana a semana (de lunes a domingo), los partidos cuyo marcador final contradijo lo que indicaban las estadísticas. Es la forma más rápida de encontrar los partidos que dan que hablar.
Para cada partido terminado, el modelo establece primero el resultado merecido, teniendo en cuenta la incertidumbre de su propia estimación. Cuando un desenlace destaca claramente sobre los otros dos, el resultado merecido es ese desenlace: la victoria de un equipo o el empate. Cuando solo se puede descartar un desenlace, pasa a ser una doble oportunidad, por ejemplo la victoria de un equipo o el empate. Cuando las estadísticas no permiten separar los desenlaces en absoluto, el partido no tiene resultado merecido y nunca aparece en la lista: un partido realmente igualado no puede ser una injusticia.
Un partido es injusto cuando el desenlace real queda fuera de su resultado merecido. La clasificación sitúa entonces primero los partidos en los que el resultado merecido daba menos opciones a lo que realmente ocurrió. Las semanas anteriores siguen disponibles, hasta el inicio de la temporada 2020-21.
Estilo de juego
Más allá de los resultados, numbertwenty describe cómo juega un equipo. El panel Estilo de juego de cada página de equipo construye un perfil a partir de sus partidos recientes, estadística por estadística, y sigue su evolución durante los últimos tres años. Los partidos recientes cuentan más que los antiguos, de modo que el perfil evoluciona con suavidad en lugar de cambiar bruscamente tras cada partido. Hay tres lecturas disponibles:
- Volumen: lo que el equipo produce en cada acción y lo que concede a sus rivales.
- Equilibrio y ritmo: quién obtiene más de cada acción (dominio) y cuánto de esa acción hay en sus partidos, sumando ambos equipos (intensidad).
- Regularidad: cuánto se aleja cada partido del estilo habitual del equipo, en una escala común a todos los equipos.
Para que las comparaciones sean justas, cada equipo solo se clasifica frente a equipos de su misma naturaleza (clubes con clubes, selecciones con selecciones), cada actuación se lee a la luz del lugar del partido y del rival, y solo se utilizan partidos jugados antes de una fecha dada. Un equipo que acumula tiros ante rivales débiles no se confunde con un equipo dominante.
Los mismos perfiles alimentan otras vistas: el estilo habitual de ambos equipos antes de un partido y cuánto se alejó cada uno de él en ese encuentro (página del partido); un mapa de estilo de todos los equipos de una competición (página de la competición); los equipos que juegan de forma más parecida; y la página Comparar el estilo de juego de los equipos, que sitúa varios equipos lado a lado en las estadísticas que elijas, según lo que producen, lo que conceden o ambas cosas.
Análisis del partido
Cada página de partido terminado incluye un breve análisis escrito en su pestaña Análisis: las estadísticas que marcaron el encuentro, qué equipo se impuso en cada faceta del juego y si el marcador final fue merecido a la luz de las probabilidades justas. El objetivo es un resumen conciso y legible para quien no vio el partido.
Los hechos van primero. Nuestro propio código selecciona las estadísticas más destacadas, a partir de las mismas señales que la pestaña Claves, y formula cada una en una frase sencilla y verificable. Un modelo de lenguaje local se limita después a convertir esos hechos en un relato legible y a reformular el veredicto de las probabilidades justas: nunca decide por sí solo qué contar, lo que mantiene el texto fiel a las cifras. Como cualquier sistema generativo, aún puede producir de vez en cuando una formulación torpe o una pequeña inexactitud; las cifras mostradas en la página siguen siendo la referencia.
Los análisis están redactados en inglés. En las versiones francesa y española del sitio, un botón Traducir este análisis traduce el texto al instante, con el traductor integrado en tu navegador si lo tiene o, si no, mediante Google Traductor. No se guarda nada por nuestra parte.
Transparencia y precisión del modelo
numbertwenty no es un motor de pronósticos. Ilustra hasta qué punto los resultados pueden variar, incluso entre partidos con estadísticas casi idénticas. El fútbol es intrínsecamente caótico y el azar forma parte de su belleza. El modelo es totalmente explicable: sin redes neuronales opacas, cada cálculo se puede rastrear.
Cada partido se presenta mediante una tarjeta de partido. Las tarjetas muestran probabilidades justas, ya sean previstas antes del partido (para los encuentros futuros) u observadas después (para los encuentros pasados). Se muestran dos insignias:
- Puntuación de singularidad (0–10): refleja la similitud media entre el partido y sus equivalentes históricos más cercanos. Una puntuación alta significa que el partido se parece mucho a otros de la competición, un partido de fútbol estándar. Una puntuación baja señala un partido raro o atípico en la historia de la competición. La pestaña Claves de la página del partido desglosa este mismo juicio estadística por estadística; véase «Explicar un partido» más arriba.
- Puntuación de previsibilidad (0–10): mide si las probabilidades previstas antes del partido (basadas en la valoración y la forma de los equipos) coinciden con las probabilidades justas calculadas después del partido a partir de las estadísticas reales. Un valor alto indica que la tendencia del partido fue coherente con lo esperado; un valor bajo señala una diferencia sorprendente entre la previsión y la realidad. Esto no implica que el resultado real fuera previsible, solo que las probabilidades justas coincidieron, o no, con lo que anticipaba el modelo previo al partido.
En conjunto, estas dos puntuaciones ofrecen una lectura rápida de si un resultado se mantiene dentro de la realidad estadística del partido o surge como un verdadero valor atípico.
En la página de detalle de un partido también puedes ver lo que el modelo predice o predijo antes del encuentro. Para garantizar la transparencia, incluso una vez jugado el partido, se muestran dos barras de probabilidad una junto a otra en cada tarjeta:
- Resultado justo: las probabilidades justas calculadas después del partido a partir de las estadísticas reales del encuentro, es decir, lo que la evidencia histórica dice que el resultado debería reflejar.
- Resultado previsto: las probabilidades previas al partido, derivadas de la valoración de los equipos y su forma reciente, antes de que rodara el balón. Comparar las dos barras revela si el partido se desarrolló como se esperaba estadísticamente o produjo un equilibrio de juego realmente sorprendente.
Comparador de partidos
Cada partido similar mostrado en el panel de vecinos es clicable. Al hacer clic se abre el comparador de partidos: una vista en paralelo del partido actual y del vecino seleccionado, con sus estadísticas, barras de percentiles, gráficos de radar y la forma reciente de los equipos.
Esto facilita entender por qué dos partidos se consideran similares (qué estadísticas coinciden y dónde divergen) y juzgar por ti mismo si el precedente histórico realmente se aplica.
Los vecinos anteriores a septiembre de 2020 se muestran pero están bloqueados para la comparación. Incluso siendo estadísticamente cercanos, estos partidos antiguos carecen de la profundidad de datos históricos necesaria para calcular percentiles y referencias contextuales fiables, lo que haría que cualquier análisis en paralelo resultara engañoso en lugar de informativo.
Ocasionalmente, un vecino se muestra con una insignia de Espejo. Significa que el vecino se encontró buscando desde la perspectiva opuesta: en los partidos en campo neutral, el modelo también busca intercambiando los papeles de equipo y rival, y luego fusiona ambos conjuntos de resultados. Un vecino en espejo es el que mejor encajaba con el partido actual desde ese ángulo invertido; sus estadísticas se muestran invertidas en consecuencia para que la comparación siga siendo significativa.
Buscador de partidos similares
El Buscador de partidos similares te permite realizar tú mismo la búsqueda de vecinos. Elige un equipo, luego uno de sus partidos pasados como referencia, limita si quieres la búsqueda a las competiciones que prefieras y fija cuántos vecinos recuperar.
Los resultados muestran cómo terminaron con más frecuencia los partidos históricos más cercanos (victoria de uno u otro equipo, o empate), qué faceta del juego distingue el partido de referencia de los partidos encontrados, y los propios partidos.
Se trata de una búsqueda exploratoria: se basa en el mismo espacio de comparación que el modelo pero omite el paso de calibración, por lo que no produce un resultado justo. Las probabilidades justas de un partido son siempre las que aparecen en su propia página.
Auditoría de apuestas postpartido
La auditoría de apuestas postpartido te permite introducir tus boletos exactos, ya sean simples o combinadas, y los evalúa frente a la huella estadística real de los partidos jugados.
En lugar de limitarse al resultado binario (ganado o perdido), el motor calcula la verdadera probabilidad empírica que tenía tu boleto de salir bien. Al cruzar tus elecciones con la distribución de marcadores generada para el partido, emite un veredicto definitivo: te dice si tuviste mala suerte de verdad en una elección inteligente, si te salvó la suerte en una apuesta arriesgada, si estabas completamente equivocado o si leíste el partido a la perfección.
El enfoque matemático
El motor de auditoría no se basa en opiniones subjetivas; utiliza un marco probabilístico estricto para calificar tus selecciones:
- Probabilidad empírica: el motor proyecta tus selecciones (1X2, más/menos goles, ambos equipos marcan, marcador exacto) sobre la matriz exacta de escenarios de partido generados por los vecinos estadísticos. Así se revela el porcentaje real de probabilidades que tenía tu apuesta de ganar según el rendimiento en 90 minutos.
- Puntuación de calidad: para cada selección, el motor calcula una puntuación de calidad comparando la probabilidad de tu elección con el óptimo matemático de ese mercado concreto. Si apostaste por un escenario con un 15 % de probabilidad cuando la opción más segura del mercado estaba en el 60 %, el motor penaliza matemáticamente el riesgo.
- Intersecciones complejas: si combinas varias selecciones en el mismo partido (por ejemplo, victoria del equipo A y más de 2,5 goles), el algoritmo no se limita a multiplicar las probabilidades, lo que sería estadísticamente erróneo. Comprueba la intersección lógica exacta de esas condiciones sobre los marcadores históricos para calcular una probabilidad condicional impecable.
- Combinadas (varias selecciones): en los boletos que combinan varios partidos distintos, el motor compone dinámicamente las probabilidades y promedia las puntuaciones de calidad de todas las selecciones para ofrecer una evaluación global y rigurosa de la viabilidad de tu combinada.
Limitaciones conocidas
Campos neutrales y juego internacional
Los partidos en campo neutral (como el Mundial o las copas continentales) tienen por naturaleza menos datos históricos que las grandes ligas nacionales como la Premier League. Aunque el decaimiento temporal basado en eventos, el ámbito dinámico de pares y la recuperación en espejo mitigan notablemente estos problemas, el modelo informa naturalmente de una varianza epistémica analítica mayor en estos partidos, para reflejar el tamaño más reducido de los conjuntos de datos subyacentes.
Un modelo en evolución
El modelo actual de análisis posterior al partido aún no es la versión definitiva. El conjunto de variables utilizado seguirá perfeccionándose a medida que avance la investigación interna. Como resultado, las probabilidades justas que se muestran hoy pueden variar ligeramente en futuras actualizaciones a medida que el modelo mejore. Todos los valores históricos se recalcularán de forma coherente cada vez que se despliegue una actualización significativa.
Sin datos posicionales ni minuto a minuto
El modelo trabaja con estadísticas agregadas del partido completo: no dispone de seguimiento posicional sobre el campo ni de visibilidad sobre cómo se desarrolló el partido en el tiempo, ni siquiera de una separación entre las dos partes. No puede distinguir un gol marcado en el minuto 2 de uno en el minuto 90, ni seguir los cambios de impulso, los efectos de una tarjeta roja o los ajustes tácticos durante el juego. Dos partidos que terminaron con la misma huella agregada pueden haber llegado allí por guiones completamente distintos, un equipo que dominó de principio a fin frente a otro que se quedó atrás pronto y presionó con fuerza para empatar, y el modelo no puede distinguirlos actualmente. Es una limitación inherente a las estadísticas agregadas, y el modelo no intenta ocultarla.
No todas las comparaciones históricas son igual de fiables
Algunos partidos tienen un conjunto de comparaciones históricas realmente ajustado y coherente; otros caen en un vecindario más desordenado, donde una mayor parte de los partidos más cercanos está moldeada por la varianza en la definición y no por un dominio estadístico limpio. El modelo mira deliberadamente un número bastante grande de partidos comparables precisamente para diluir este tipo de ruido, y pondera con más cuidado los resultados menos frecuentes (como los empates) por la misma razón, pero hoy no señala, caso por caso, si las comparaciones de un partido concreto son inusualmente ruidosas o inusualmente limpias.
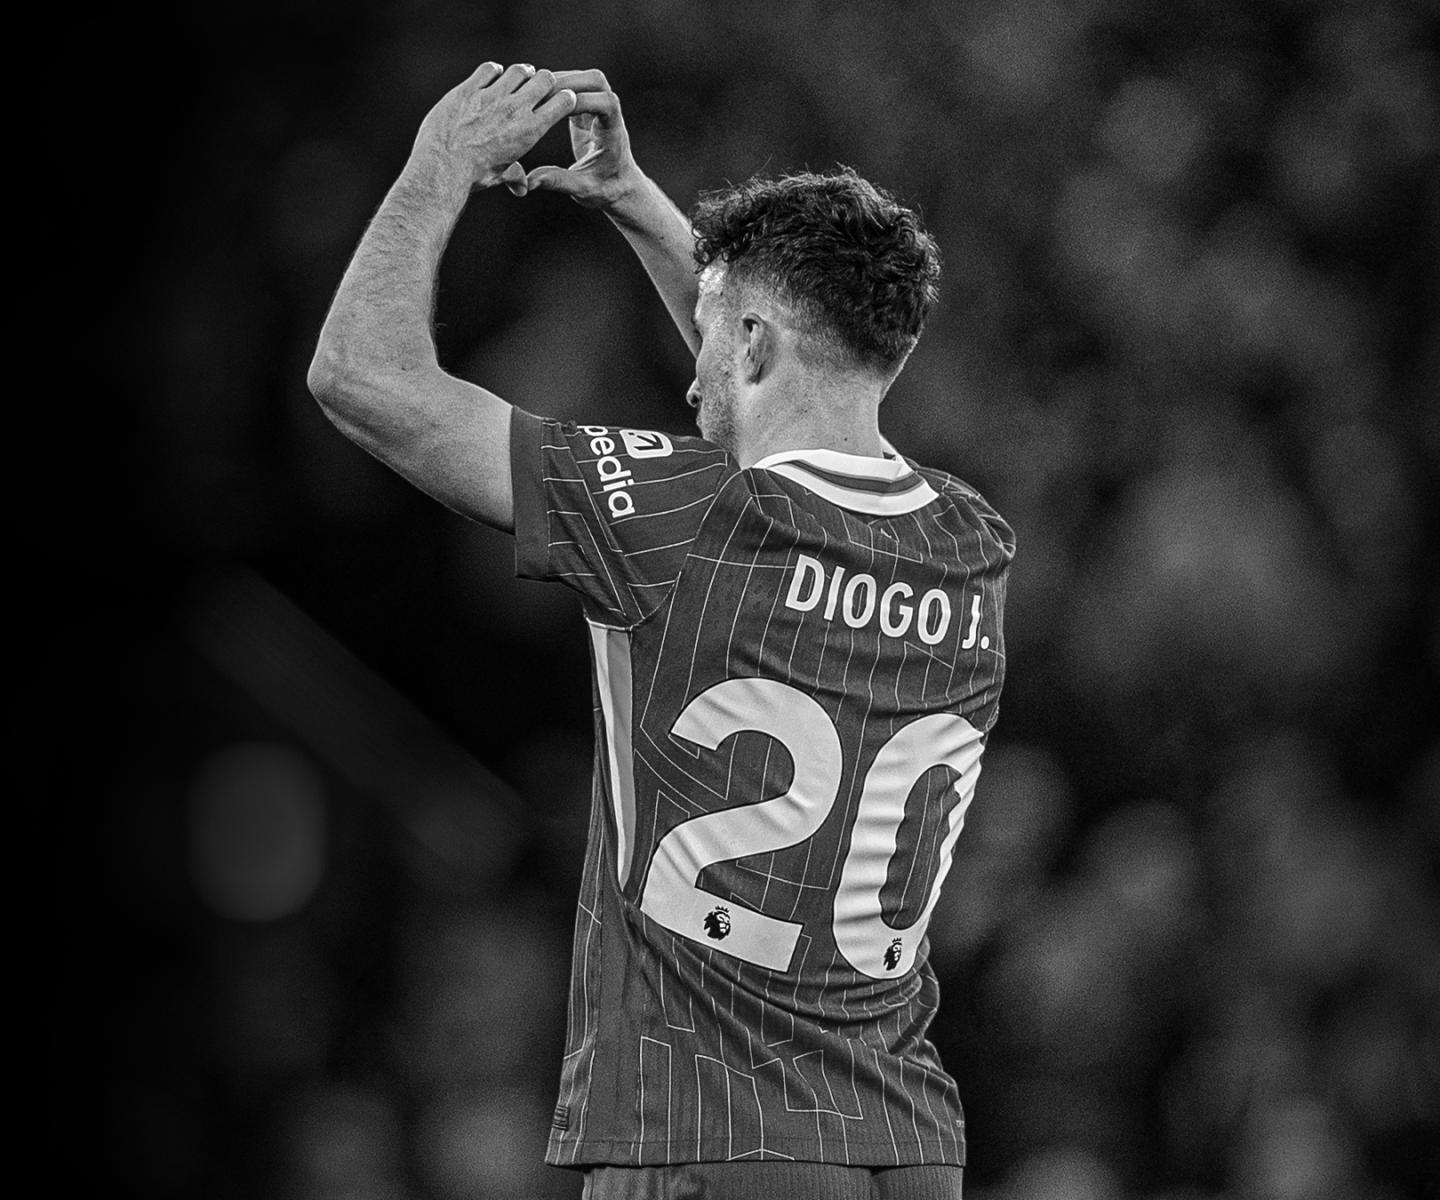
Siempre nuestro número 20
